1 августа 2026 г.
Что такое контекстное окно нейросети и почему она «забывает»
Почему ChatGPT теряет нить длинного диалога и «не дочитывает» большие документы: объясняем контекстное окно на пальцах и показываем, как обходить лимит.
- #словарь
- #нейросети
- #контекстное окно
Знакомая ситуация: полчаса обсуждаете с ChatGPT проект, а он вдруг переспрашивает то, что вы объяснили в начале. Или вставляете большой документ — а нейросеть отвечает так, будто прочитала только половину. Скорее всего, так и есть. Причина называется «контекстное окно нейросети» — и это самое полезное понятие для всех, кто работает с ИИ.
Бытовая аналогия
Контекстное окно — это рабочий стол ограниченного размера. Всё, что на столе, нейросеть видит и учитывает: ваш вопрос, документ, историю переписки. Что на стол не поместилось — для неё не существует.
Когда диалог разрастается, стол переполняется, и старые листы начинают сползать на пол. Модель не «забыла» начало разговора в человеческом смысле — оно физически перестало помещаться в то, что она видит. Отсюда и переспросы.
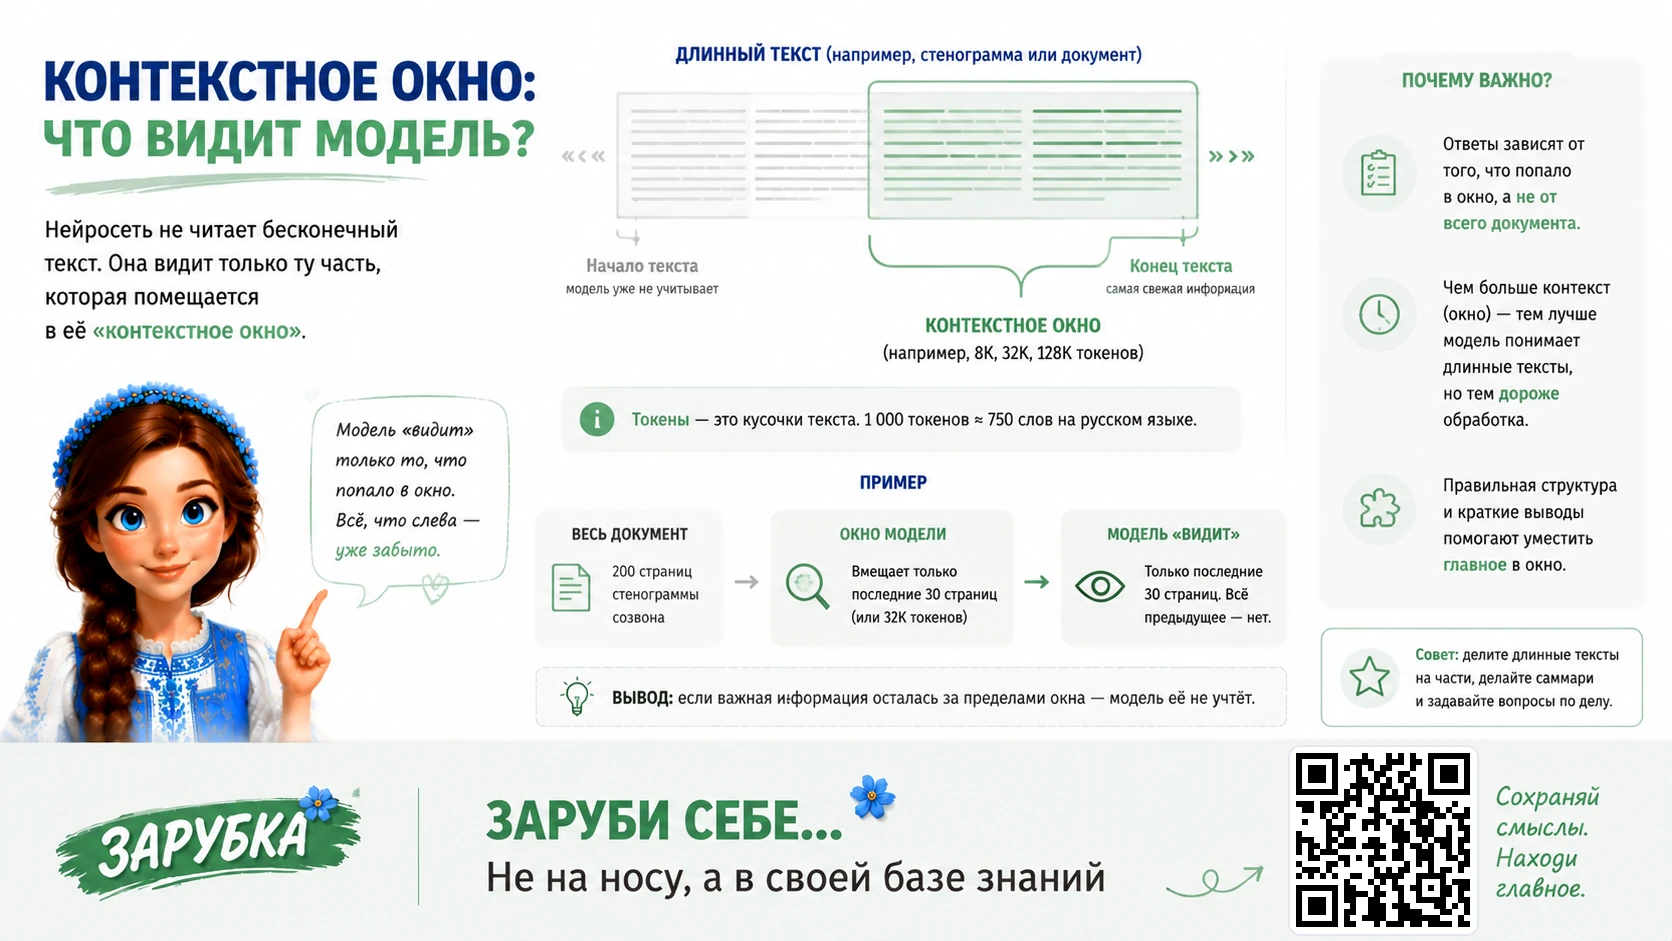
Размер стола меряют в токенах — кусочках слов. Для ориентира: страница текста — примерно 500 токенов, у популярных моделей окна от 128 тысяч токенов (том «Войны и мира» примерно) до миллиона и больше. Звучит огромно, но часовой созвон — это 30–50 страниц расшифровки, а месяц таких созвонов уже не влезет никуда.
Зачем это знать обычному человеку
Понимание окна снимает главное разочарование в нейросетях — «она тупит на длинном». Три практических следствия:
- Длинный диалог — новый чат. Если сессия разрослась, полезнее начать заново и первым сообщением коротко пересказать, что уже решили.
- Большой документ — по частям или выжимкой. Модель охотнее и точнее работает с конспектом на три страницы, чем с сотней страниц сырого текста.
- Важное — ближе к концу. Середину длинного контекста модели читают хуже всего (это подтверждено тестами и называется «lost in the middle»), поэтому ключевую инструкцию лучше повторить в конце промпта.
При чём тут базы знаний
Контекстное окно — главная причина, почему нельзя просто «скормить нейросети всё и сразу». Архив накопленных материалов в окно не влезет никогда. Обходят это два приёма.
Первый — сжатие: хранить не сырые записи, а конспекты. Часовое видео, сжатое до страницы главных мыслей, занимает в окне в тридцать раз меньше места — именно поэтому в ЗАРУБКЕ каждый материал превращается не только в расшифровку, но и в структурированный конспект (как это выглядит — в статье про конспекты из YouTube).
Второй — умный поиск: не класть на стол всё, а находить и подкладывать только те куски, которые относятся к вопросу. Так работает подход RAG — о нём следующая статья словаря: «Что такое RAG простыми словами».
Про размеры окон у свежих моделей и что они значат на практике — пишу в канале «Очередная нейросеть».
Попробуйте на своём материале
Пришлите голосовое, видео или ссылку — через пару минут получите текст и конспект. Начните с трёх бесплатных генераций, карта не нужна.
Открыть бот